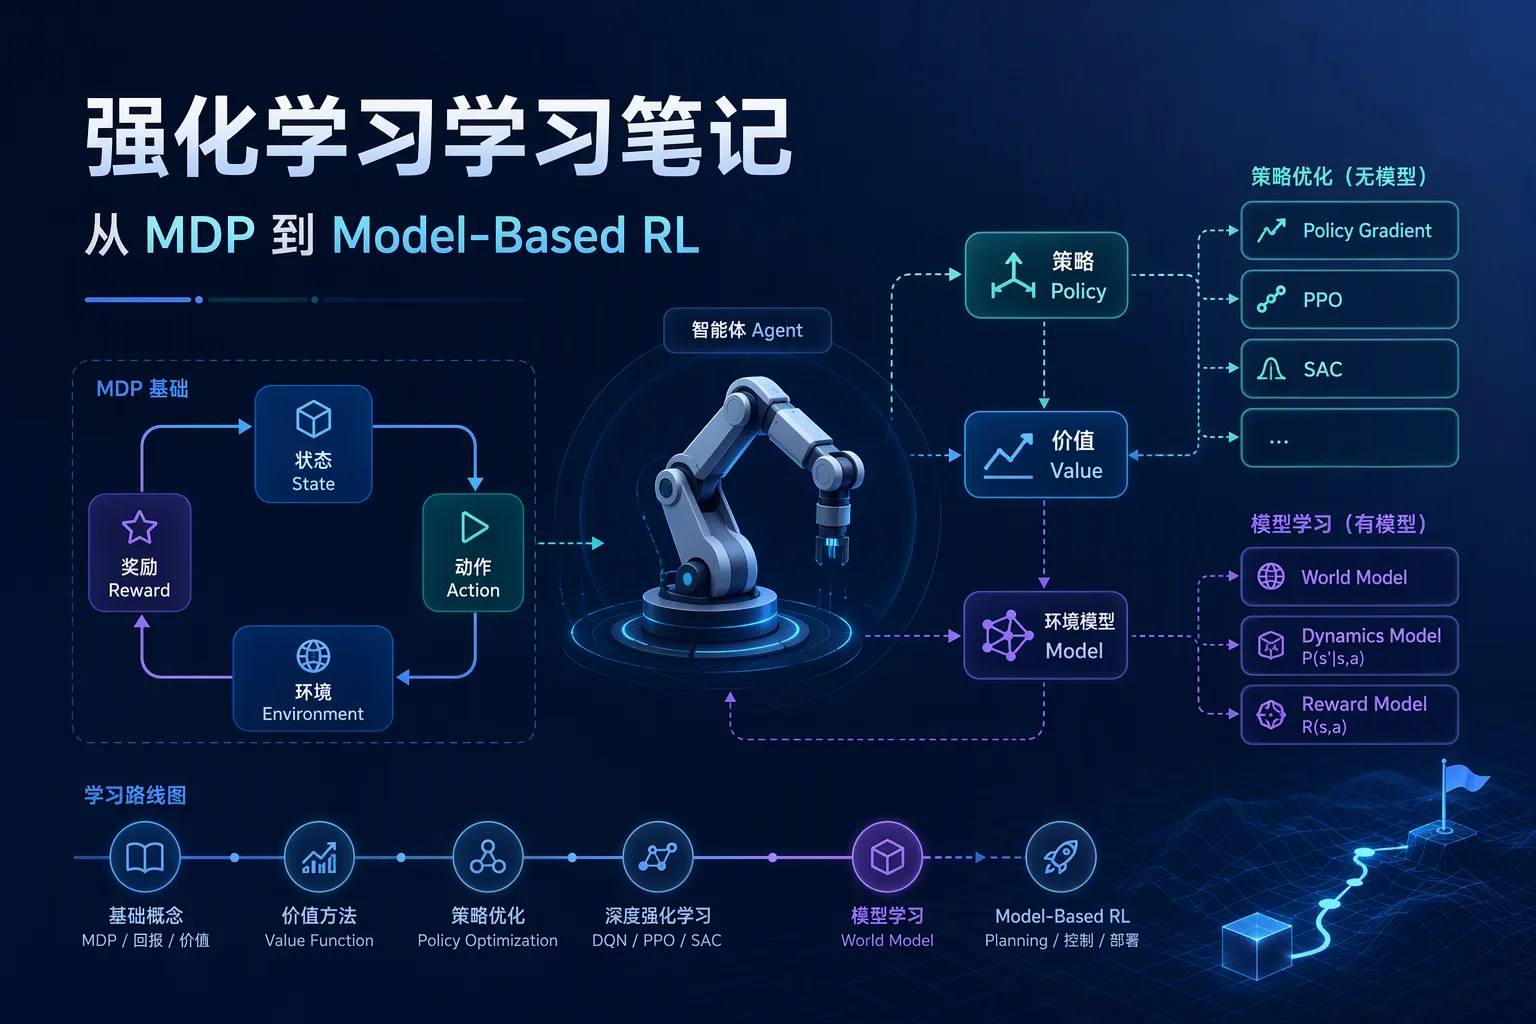
强化学习学习笔记:从 MDP 到 Model-Based RL2026-09-042026-09-26技术笔记强化学习/RL/人工智能本文是一份强化学习基础梳理。先交代 Agent 与 Environment 的交互,把 reward 折成 return;再用状态价值与动作价值,加上 Monte Carlo 和 TD 两条估计路线,说明"策略好不好"该怎么衡量;最后是值方法与策略方法这两条主线,从 SARSA 一路讲到 PPO 与 SAC,再落到 model-based RL 与模仿学习。2026-09-04|2|0|0