强化学习学习笔记:从 MDP 到 Model-Based RL
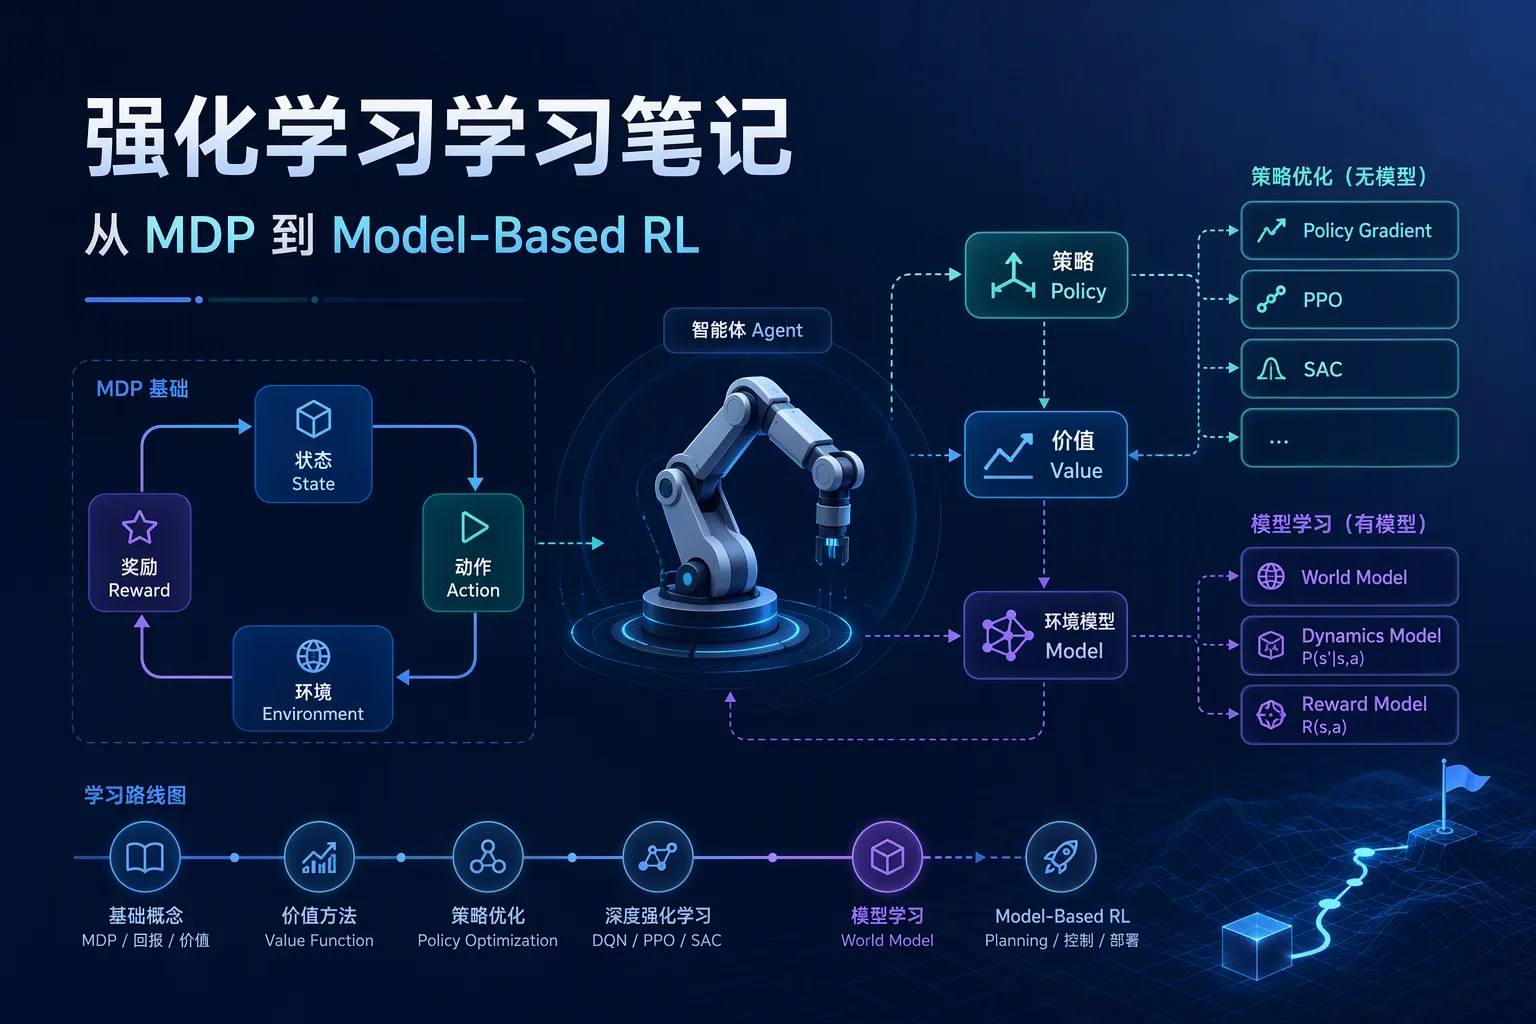
本文是一份强化学习基础梳理,偏学习向,不追求数学上的严格完备。
目的是把散落在各个教程里的名词串成一条能走通的线:一次交互长什么样 → 怎么描述它 → 怎么评价策略 → 怎么改进策略 → 现在都有哪些流派。本文参考视频:https://www.youtube.com/watch?v=VnpRp7ZglfA
写在前面
强化学习最劝退的地方是概念太多且互相缠绕:MDP 与 return、value function 与 TD,再加上 on-policy、model-free 和 world model 这些名词,单独看每个都懂,放在一起就不知道谁指向谁。
全文按一条推理链往下走:先定义交互本身,再定义“好”的度量,再定义“怎么估计这个度量”,最后才是各种算法名字。算法只是“在哪个位置做了哪种近似”的产物。
1. 一次交互里有哪些东西
强化学习最基本的元素:
- Agent:智能体,做决策的一方
- Environment:环境,agent 之外的一切
- State s:状态
- Action a:动作
- Reward r:奖励
交互过程可以写成:
拆成三条边走:
Environment -> State -> Agent
Agent -> Action -> Environment
Environment -> Reward + Next State
也就是:agent 根据当前状态选一个动作,环境执行这个动作,返回新的状态和一个 reward。整个过程反复进行,没有"正确答案"这种东西,只有反馈。这也是 RL 和监督学习最根本的区别。监督学习每个样本都带标签,RL 只有一个标量奖励,而且这个奖励还只是"这一步做得好不好"的间接信号。
2. Markov 性与 MDP
Markov Chain
Markov Chain 描述一个随时间反复发生的随机状态转移过程:
Markov 性质
一个常见的粗略说法是:
每一个状态只和前一个状态有关。
更准确的说法是:
给定当前状态后,未来与更早的历史条件独立。
这里的区别在于,把 Markov 性质读成“s_t 由 s_{t-1} 唯一决定”,那就成了确定性系统;它说的是
当前 s_t 已经包含了预测未来所需要的全部信息。
所以 Markov 性质本质上是一个关于状态表示的信息完整性要求,而不是关于转移矩阵有多简单的假设。这一点在后面 Bellman 最优性原理那里会再次出现,如果状态漏了信息,整套理论的地基就是松的。
MDP
Markov Chain 加上 action、reward 与 policy,就得到强化学习最基本的数学模型:
即 Markov Decision Process。
3. Episode 与 Trajectory
Episode 是"一次完整的交互过程"。以游戏为例:
开局 → 一系列操作 → 死亡 / 胜利
一条 trajectory 则是:
Episode 可以理解成"一整局",而 trajectory 更泛化,可以只是其中一段状态-动作序列。区分这两个词的意义在于:有些算法必须等 episode 结束才能学(Monte Carlo),有些不用(TD),而有些任务干脆没有天然的 episode 边界(比如持续运行的机器人)。
4. Policy
Policy 描述在某个状态下 agent 应该采取什么动作。确定性的 policy 写作:
随机 policy 写作:
即在状态 s 下采取动作 a 的概率。
确定性策略可以看成随机策略的一个特例(某个动作概率为 1)。用随机策略的理由通常有两个:一是天然带探索性,二是连续控制场景下分布本身能表达"这里有多个合理选择"。
5. Reward、Return 与折扣
Reward:
只是某一个时间步的即时奖励。
Return:
表示从 t 时刻开始,未来所有 reward 的折扣累计值。
这个区分是 RL 里最容易混的一对:reward 是环境给的即时反馈,return 才是 agent 真正要最大化的目标。把 return 不加折扣地求和可能出现无穷大,也可能让 agent 觉得"反正以后还有机会",所以引入折扣因子。
Discount Factor
直觉上:
现在拿到的奖励,比很久以后才能拿到的奖励更"值钱"。
- \gamma 小:短视,更看重眼前
- \gamma 大:更考虑长期结果
\gamma 还会决定有效视野的长度大约在 1/(1-\gamma) 这个量级,这在实际调参时比"0.99 听起来挺合理"更有参考价值。
Return 的递归形式
因为:
两边乘 \gamma 再加上 r_t:
这实际上已经是后面 Bellman equation 的雏形。整个 RL 的值方法几乎都是从这个递归式展开出来的。
6. Environment Model
Model 指环境的动力学:
意思是:当前处于 s,执行 a 之后,得到 reward r 并进入 s' 的概率。
有没有这个模型,是后面 Model-free 和 Model-based 两大流派的分界线。
7. Value Function
State Value Function
含义:从状态 s 开始,之后一直按照策略 \pi 行动,预期能获得多少 return。
Action Value Function
含义:在状态 s 先执行动作 a,之后再遵循 \pi,预期能获得多少 return。
定义 Q 时最容易漏掉动作这一步:
动作价值函数 Q:处于某个状态预期能获得多少回报。
完整的表述是:
处于某个状态并且采取某个动作之后,预期能获得多少回报。
V 和 Q 差的那一步动作,恰恰是"策略改进"能发生的地方,只有知道每个动作分别值多少,才有得比较。
最优价值
表示所有可能 policy 中能达到的最高 expected return。
8. Policy Evaluation
Policy evaluation 是:已经给定一个 policy \pi,现在评价它到底有多好。
本质上就是估计 V^\pi 或 Q^\pi。
注意它和"找最优策略"是两件事:评估是打分,不改策略;改进才改策略。把这个循环反复执行,就是后面要讲的 GPI。
9. 两条估计价值的路线:Monte Carlo 与 TD
Monte Carlo
思路很直接:真的把一局跑完,然后用实际获得的 return 去估计价值。
也可以理解成"随机多试几次,统计平均结果":
优点:
- 不需要环境 model
- 概念简单,完整 episode 的 sampled return 可以作为价值的无偏样本
缺点:
- 必须等 episode 结束
- variance 较大
Temporal Difference(TD)
TD 不需要等整局结束:
根据当前 reward 和下一状态的估计值,立刻更新当前估计。
其中
叫 TD error。
TD 用"自己当前的估计"去更新"自己当前的估计",也就是 bootstrap。代价是引入了 bias(因为估计值本身不准确),换来的是低 variance 和在线更新能力。Monte Carlo 和 TD 的这一对 bias-variance 取舍,后面在 GAE 那里还会再见到一次。
10. 从 SARSA 到 Q-learning
SARSA
名字就来自它用到的五元组:
更新式:
直觉是:
这一步实际得到的结果,比原先的估计更好还是更差?
它评价的是:到达新状态之后,按照当前 policy 实际采取的那个动作。
所以 SARSA 是 on-policy 的。
Expected SARSA
SARSA 用实际采样的那个 Q(s', a'),Expected SARSA 则对新状态下所有动作按 policy 概率求期望:
也就是:
回报比预期更好还是更差,是相对于新状态下按 policy 对所有动作加权平均后的价值。
因为不再依赖单次采样的动作,variance 通常比普通 SARSA 更低。
On-policy 与 Off-policy
- On-policy:behavior policy = target policy,"用什么策略采样,就学习什么策略"。例如 SARSA、PPO。
- Off-policy:behavior policy ≠ target policy,可以用一个策略收集数据,却去学习另一个策略。例如 Q-learning。
Off-policy 的价值在于数据可以复用(历史数据、别人产生的数据,还有探索性很强的数据),这在 sample efficiency 敏感的场景里很关键。
Q-learning
和 SARSA 唯一的、也是最本质的区别:
| 算法 | 更新时用的目标 |
|---|---|
| SARSA | Q(s', a_{\text{actually taken}}) |
| Q-learning | \max_a Q(s', a) |
即:
它不管下一步实际采取什么动作,直接假设以后会采取当前估计里的最佳动作。
它也因此直接逼近 Q^*,属于 off-policy。也正因为这个 \max,Q-learning 在探索不充分时容易高估价值(overestimation),后来的 Double DQN 就是在处理这个问题。
11. GPI:评估与改进的循环
核心循环:
Policy Evaluation
      ↓
估计 Qπ / Vπ
      ↓
Policy Improvement
      ↓
让 policy 更倾向高价值动作
      ↓
重新 Evaluation
      ↓
...
写成链式就是:
直到接近 Q^*。这叫 Generalized Policy Iteration(GPI)。
几乎所有值方法都可以看成 GPI 的某种近似版本:评估得不完全没关系,改进得不彻底也没关系,只要循环还在往"两者互相靠近"的方向走。
12. Bellman 最优性原理
Bellman 最优性原理说:
如果一条完整策略是全局最优的,那么从这条最优策略的任何一个中间状态开始,后续策略也必须是针对那个状态的最优方案。
注意它没有说:
每一步都必须让即时 reward 最大。
它要求的是:
从当前状态开始,整个未来的累计 return 必须最优。
它成立的重要前提之一,就是前面提过的:
state s_t 必须包含足够的信息。
否则同一个"state"由于不同历史可能需要不同策略,Markov 性质失效,这个原理也就不成立了。
对应的 Bellman optimality equation:
核心思想:
当前最优价值 = 当前 reward + 下一状态的最优未来价值。
左边是要算的未知量,右边又出现了它自己。有限且已知的 MDP 可以直接求解,在状态空间较大或未知时,通常通过迭代或函数逼近求解。这也解释了为什么 RL 的算法几乎都长得像"不断把估计往这个自洽条件上拉"。
13. 为什么大家都在意 Sample Efficiency
Sample efficiency 指的是:为了学到一个性能不错的 policy,需要多少次环境交互。
这件事在有仿真环境时还好说:
跑 100M steps 可能只是算力问题。
但换成真机:
100M 次机械臂操作基本不可接受。
这大概是 model-free RL 在真实机器人上最核心的痛点。算法排行榜上差几个点,和"能不能在真机上跑完训练",完全是两个量级的问题。
14. 用神经网络近似 Q:DQN
Q-learning 在状态空间很大时,不可能维护一张 Q-table。于是用神经网络 Q_\theta(s, a) 来近似 Q function。
DQN 属于 value-based deep RL,典型特点:
- state 可以是高维甚至连续的
- action 通常必须是离散的
比如:
left
right
fire
jump
Lunar Lander 就是经典例子。
准确的描述是:
DQN:value-based;可以处理高维 / 连续 state,但通常要求 discrete action。
因为网络输出的是"每个离散动作的价值",连续动作下这个 \arg\max 就没法直接算了。
15. 直接学策略:Policy Gradient
另一条路线直接学策略,不去学 Q(s,a) 再 \arg\max:
定义 performance objective:
目标是最大化它:
这两类训练的更新方向也因此不同。
- 普通神经网络训练:gradient descent
- Policy Gradient:对 J 做 gradient ascent
实际实现里也常写成最小化 L = -J,然后照旧用 gradient descent 的框架跑。
这条路线的优势是天然支持连续动作和随机策略,代价是梯度估计的 variance 通常更大。
Advantage
含义是:这个动作相比"这个状态下的平均水平"究竟好多少。
用 advantage 替代原始 return 作为加权信号,可以直接消掉"这个状态本身好不好"的影响,只保留"这个动作选得对不对",梯度估计的 variance 会明显降低。
GAE
Generalized Advantage Estimation 用来更稳定地估计 advantage,核心是在
- bias
- variance
之间做折中(通过一个 \lambda 参数把多步的 TD error 加权混合)。
在 PPO 的实现里非常常见,基本上看到 PPO 就会看到 GAE。
16. Actor-Critic
Actor-Critic 把两类方法结合起来:
Actor
负责选择动作。
Critic
负责判断这个动作 / 状态到底好不好。
Actor:我该干什么?
Critic:你干得怎么样?
Policy gradient 需要知道"刚做的事到底好不好"才能算加权,Critic 就是提供这个信号的来源。这也是 PPO、SAC 这类主流算法的骨架。
17. TRPO 与 PPO:别一步走太远
TRPO(Trust Region Policy Optimization)的思路是:限制一次 policy update 不要变化太大。
PPO(Proximal Policy Optimization)用更简单的 surrogate objective 达到类似目的,著名的 clipped objective:
核心就一句话。
Policy 可以更新,但别一步走得太远。
原因也很直白。策略梯度是从"当前策略产生的数据"上估出来的,策略一变,数据分布就跟着变,步子迈太大这批数据立刻就过期了,更新方向也就不再可信。
在人形机器人 RL 里,最常见的就是 PPO,配套的往往是一大堆 reward term 的设计和调参。
18. SAC:给 reward 加一点熵
Soft Actor-Critic 是一种 off-policy actor-critic 方法。
它不只希望 reward 高,还额外加入 entropy 项:
即鼓励:
policy 不要过早变得过于确定,保持一定探索性。
熵项相当于把"探索"直接写进了优化目标,而不是靠外部噪声或者 \epsilon-greedy 去维持。SAC 在 continuous control 场景里非常常见,也是 off-policy 高 sample efficiency 路线的代表。
19. 题外话:TD error 与多巴胺
回到 TD error:
有一类神经科学解释认为:dopamine response 和 reward prediction error / TD error 有某种对应关系。例如:
- 比预期好 → 正 prediction error
- 和预期一样 → 接近 0
- 比预期差 → negative prediction error
还有人用 actor-critic 框架去解释 basal ganglia / striatum 的机制,这属于 RL 和 computational neuroscience 的交叉地带。
不过要小心一件事:
不要理解成"人脑真的严格运行 PPO / actor-critic"。
它更多是一种解释模型,能解释一部分实验现象,不等于脑内真的存在一个显式的 V_\phi 网络。
20. "Deep RL Doesn't Work Yet"
Deep RL 虽然在很多 benchmark 上表现惊艳,但仍然存在严重的工程问题。
典型的问题有这几个。
- sample inefficient
- 训练不稳定
- 对 hyperparameter 极度敏感
- reward engineering 成本高
- reproducibility 差
- sim-to-real gap
- exploration 困难
在机器人 RL 的论文里,方法本身可能只有几行公式,真正决定成败的却是 reward 怎么写、训练怎么稳定下来,以及换个随机种子结果会不会崩。PPO 加上一大堆 reward engineering 之所以难做,原因就在这里,它更接近系统工程,而不是把一个理论验证一遍。
21. Model-free 与 Model-based
Model-free RL
不显式学习或使用 environment transition model。
常见的 model-free 方法有这几种。
- Q-learning
- DQN
- PPO
- SAC
所以 PPO 这类方法都属于 model-free RL,它们的核心问题前面已经说过:sample efficiency 太差,在真机 robotics 场景尤其明显。
Model-based RL
Agent 拥有或者学习一个 world model,然后利用这个 model 做决策或训练。
获取 world model 的两条路:
- 人工构造(handcrafted):环境动力学由已知的物理规律或 simulator 提供。例如 Newton dynamics、MuJoCo 和 Isaac Sim。
- 从数据学习(learned):从 (s_t, a_t) \rightarrow s_{t+1} 的数据里学,现代方法更倾向于学 latent dynamics / world model。
使用 world model 的两种方式:
- Train with imagined experiences:在 learned model 里"想象"大量 trajectory,
不用每一次都与真实环境交互。代表是 Dreamer 这类方法。
- Decision-time planning:在真正做决策时才用 model 搜索未来,不提前把所有知识压进 policy。代表是 Monte Carlo Tree Search(MCTS),AlphaGo / AlphaZero 是经典案例。
这两条路线的取舍也很清楚:前者想省交互,但要承受 model error 被 rollout 放大的风险;后者每次决策都要付搜索的计算成本,换来的是不把模型误差固化进参数里。
22. 从示范里学:BC / DAgger / IRL
Imitation Learning
目标是直接从 expert demonstrations 学,不完全依赖 reward 自己摸索。对 robotics 尤其重要,很多时候"奖励函数怎么写"根本说不清,但"人做一遍"是容易的。
Behavioural Cloning(BC)
最简单的 imitation learning。给定 dataset (s, a),直接做监督学习:
即"看专家在这个 state 做了什么,我照着学"。
最大问题是 distribution shift / compounding error:一旦自己走进专家 dataset 没覆盖的 state,动作就会开始出错,出错又会把状态推得更偏,越错越远。
DAgger
Dataset Aggregation,解决 BC distribution shift 的经典方法:
先训练 policy
↓
让 policy 自己运行
↓
遇到新的 state
↓
让 expert 给正确 action
↓
加入 dataset
↓
重新训练
所以 dataset 会不断覆盖"learner 自己真正会遇到的状态",而不是专家会遇到的状态。代价是训练过程需要 expert 持续在线。
Inverse Reinforcement Learning(IRL)
普通 RL:
reward function
      ↓
learn policy
Inverse RL:
expert behaviour
      ↓
反推 reward function
也就是:看专家怎么做,然后尝试推测专家究竟在优化什么。它的吸引力在于,reward function 才是"任务定义",一旦反推出来,就可以在新的环境、新的动力学下重新求解最优策略。
23. 最后把整张地图压缩一下
按流派整理成一棵树:
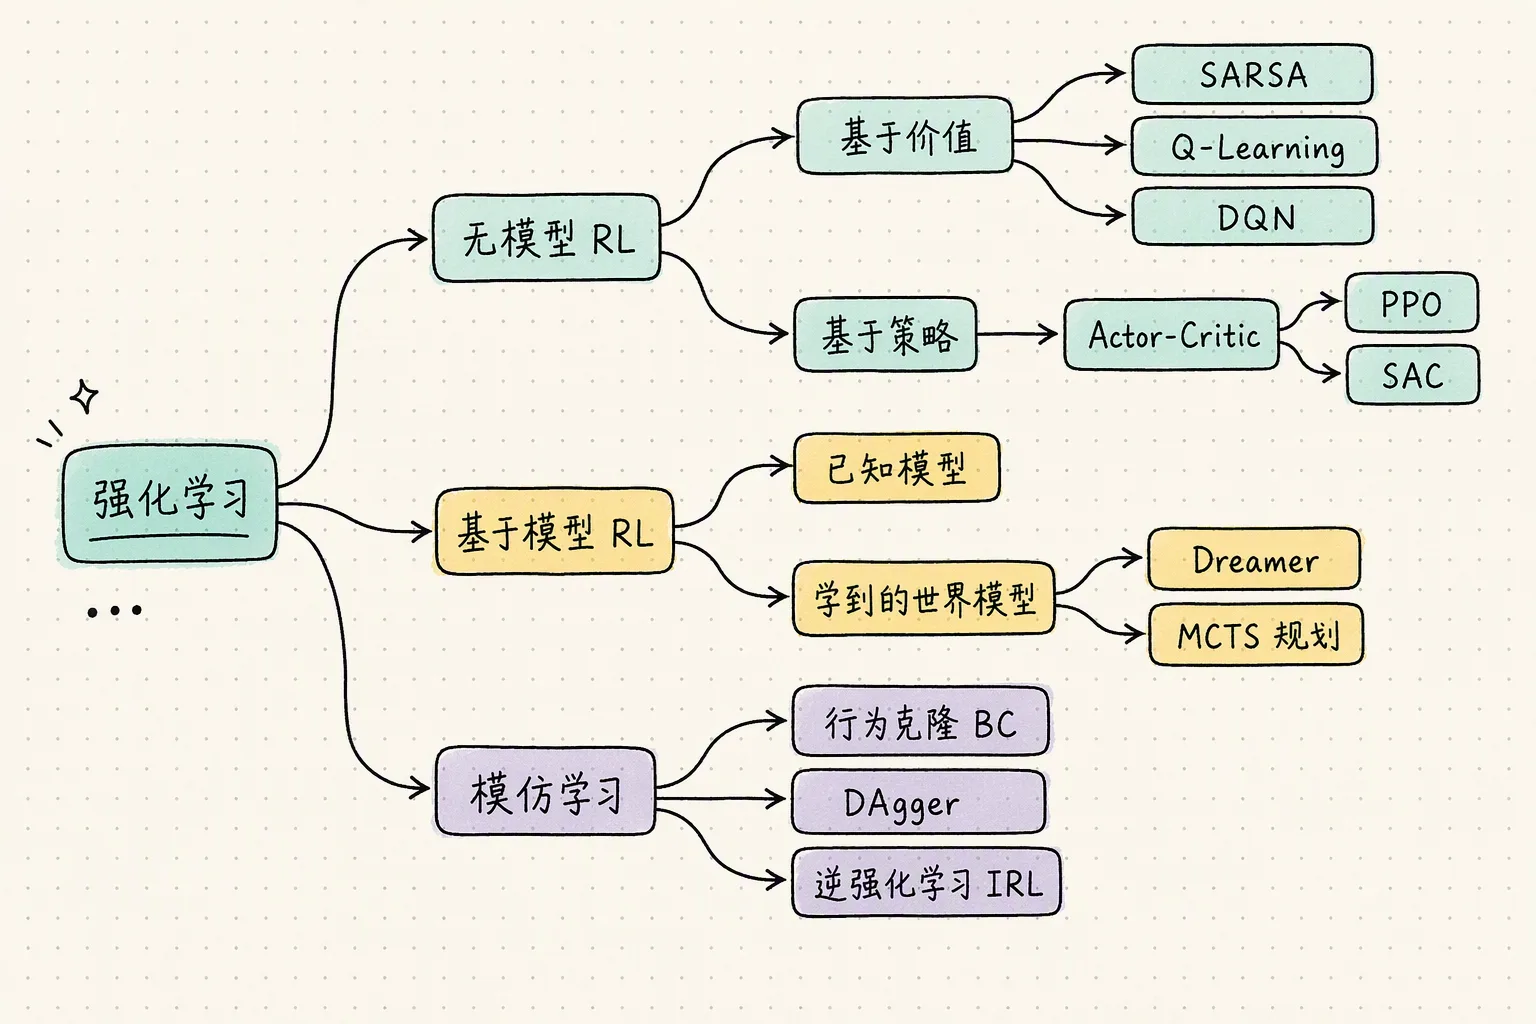
再回头看,会发现整条主线其实只有三步:
- 定义"好":把 reward 折成 return,再用 V^\pi / Q^\pi 去衡量。
- 估计"好":Monte Carlo、TD、函数逼近,各自在 bias、variance、sample efficiency 之间做交易。
- 利用"好":改策略(GPI、policy gradient、actor-critic),同时别把估计误差直接用太狠(TRPO / PPO / SAC)。
至于 model-based 和 imitation learning,可以理解成在"怎么少跟环境交互"这个问题上,另外两条越走越宽的岔路。