港中深 CSC5001 课程笔记|从循环到递归:算法复杂度分析入门2026-09-122026-09-27技术笔记算法复杂度/算法分析/CSC5001/课程笔记从循环到递归,重新梳理算法复杂度分析的基本思路:怎么数执行次数,怎么把求和化成渐进复杂度,又怎么从递推关系看出算法的增长规律。一篇写给自己的 CSC5001 入门笔记。2026-09-12|22|0|0
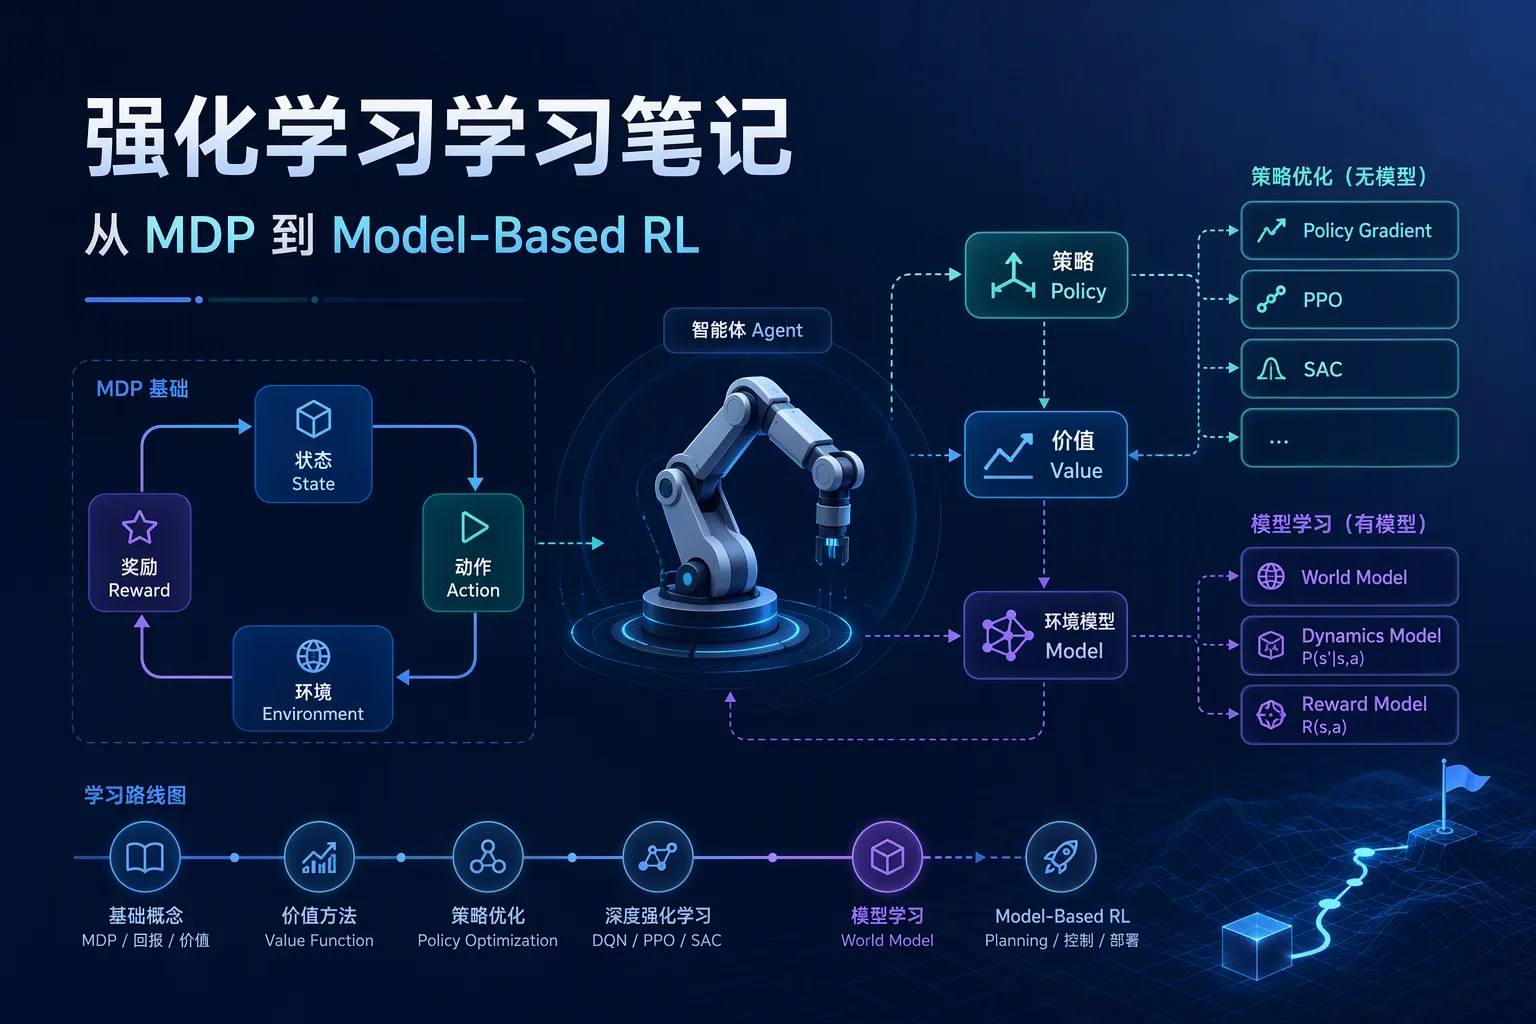
强化学习学习笔记:从 MDP 到 Model-Based RL2026-09-042026-09-26技术笔记强化学习/RL/人工智能本文是一份强化学习基础梳理。先交代 Agent 与 Environment 的交互,把 reward 折成 return;再用状态价值与动作价值,加上 Monte Carlo 和 TD 两条估计路线,说明"策略好不好"该怎么衡量;最后是值方法与策略方法这两条主线,从 SARSA 一路讲到 PPO 与 SAC,再落到 model-based RL 与模仿学习。2026-09-04|28|0|0
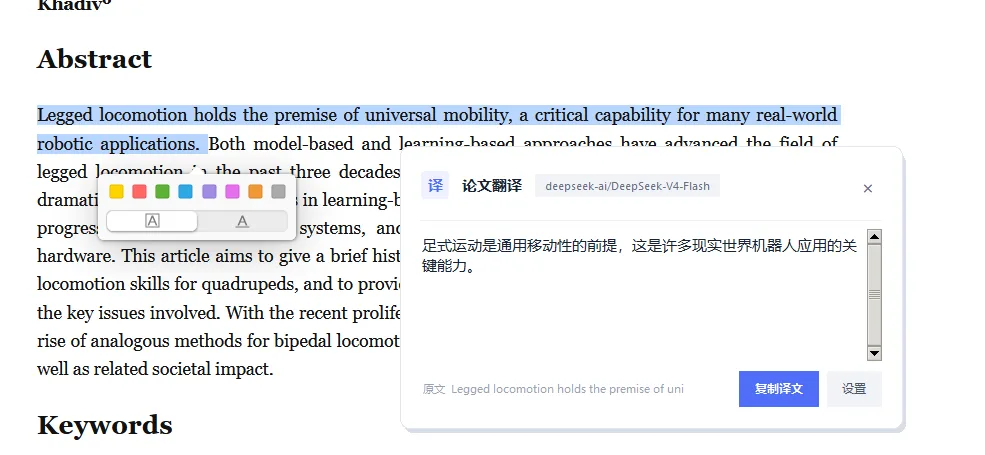
轻译:适用于 Zotero 10 的极简划词翻译器2026-08-252026-08-25技术笔记Zotero/人工智能/桌面应用/Python轻译是作者自研的 Windows 桌面端 + Zotero 插件组合,解决一个具体需求:在 Zotero 10 的 PDF阅读模式里划选文本、右键即可调用自配的 LLM API 完成翻译。文章按三步介绍了安装使用流程(配置桌面端、安装启用连接器插件、划词翻译),并强调工具定位——极简、轻量、快捷,专注覆盖读英文论文时最常见的翻译场景。2026-08-25|50|0|0
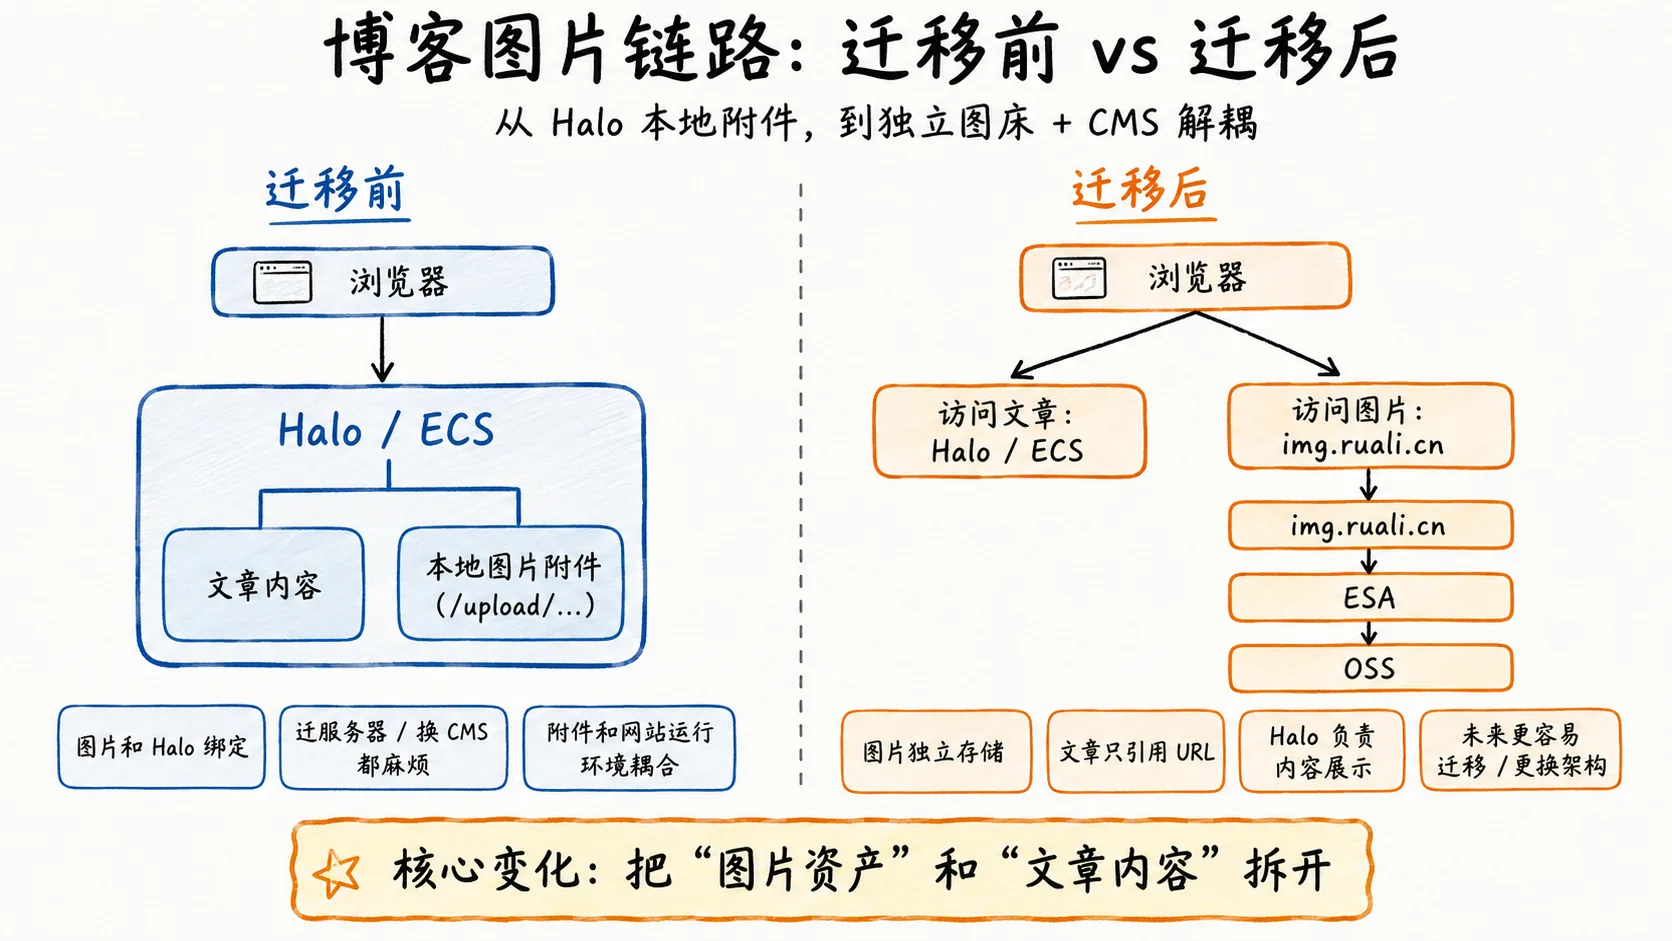
阿里云 ESA + OSS 搭建个人网站图床2026-08-152026-08-15技术笔记图床/个人网站/#阿里云 ESA/#边缘安全加速文章积累四十多篇后,图片一直存在 Halo 本地存储,占服务器资源、耦合严重。本文记录改用阿里云 ESA + OSS 搭建图床的过程:为什么选 ESA,以及建 Bucket、ESA 回源联动、批量迁移历史图片URL 的具体操作,最终让文章与服务器彻底解耦。2026-08-15|40|0|1
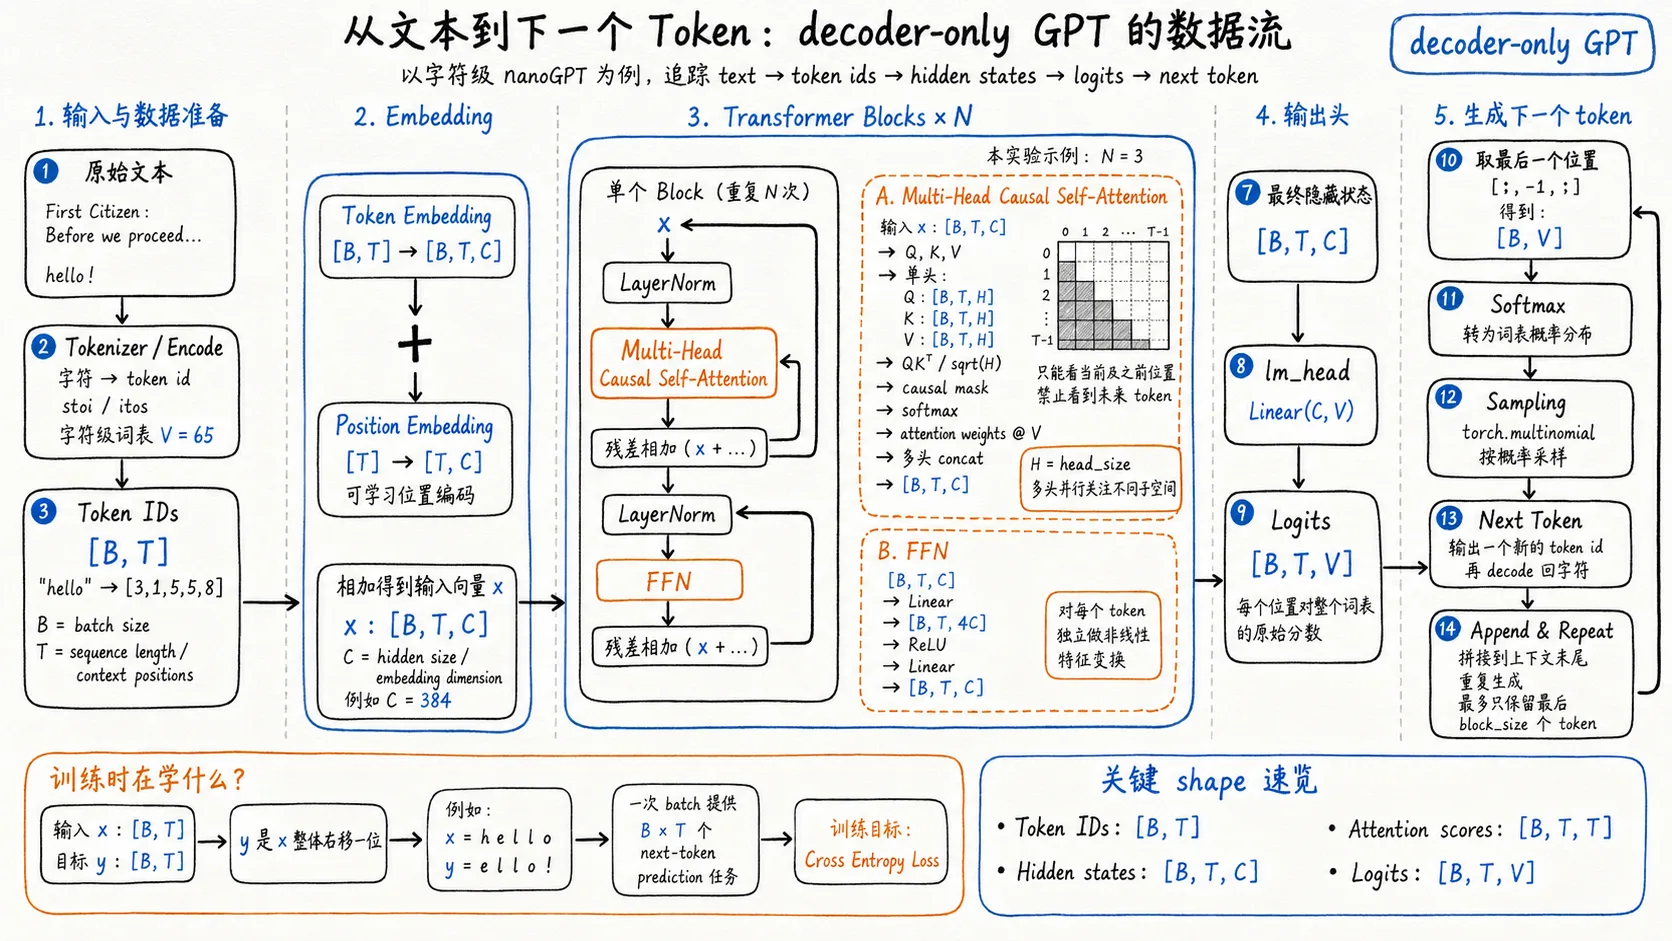
从零实现 GPT:Karpathy nanoGPT 学习笔记2026-08-102026-08-14技术笔记GPT/transformer/Pretraining/预训练跟随 Karpathy 的 nanoGPT 教程,用 PyTorch 从零实现了一个字符级 decoder-only Transformer 语言模型,在莎士比亚数据集上训练出约 5.47M 参数的小模型。文章沿数据流梳理了 token 化、Embedding、位置编码、多头注意力、LayerNorm、FFN 等核心结构,并记录了训练配置与 loss 曲线。最终模型虽远不及现代 LLM,但已能输出拼写正确、颇具"莎士比亚风味"的文本——核心是理解了 GPT 的基本工作机制。2026-08-10|82|0|0
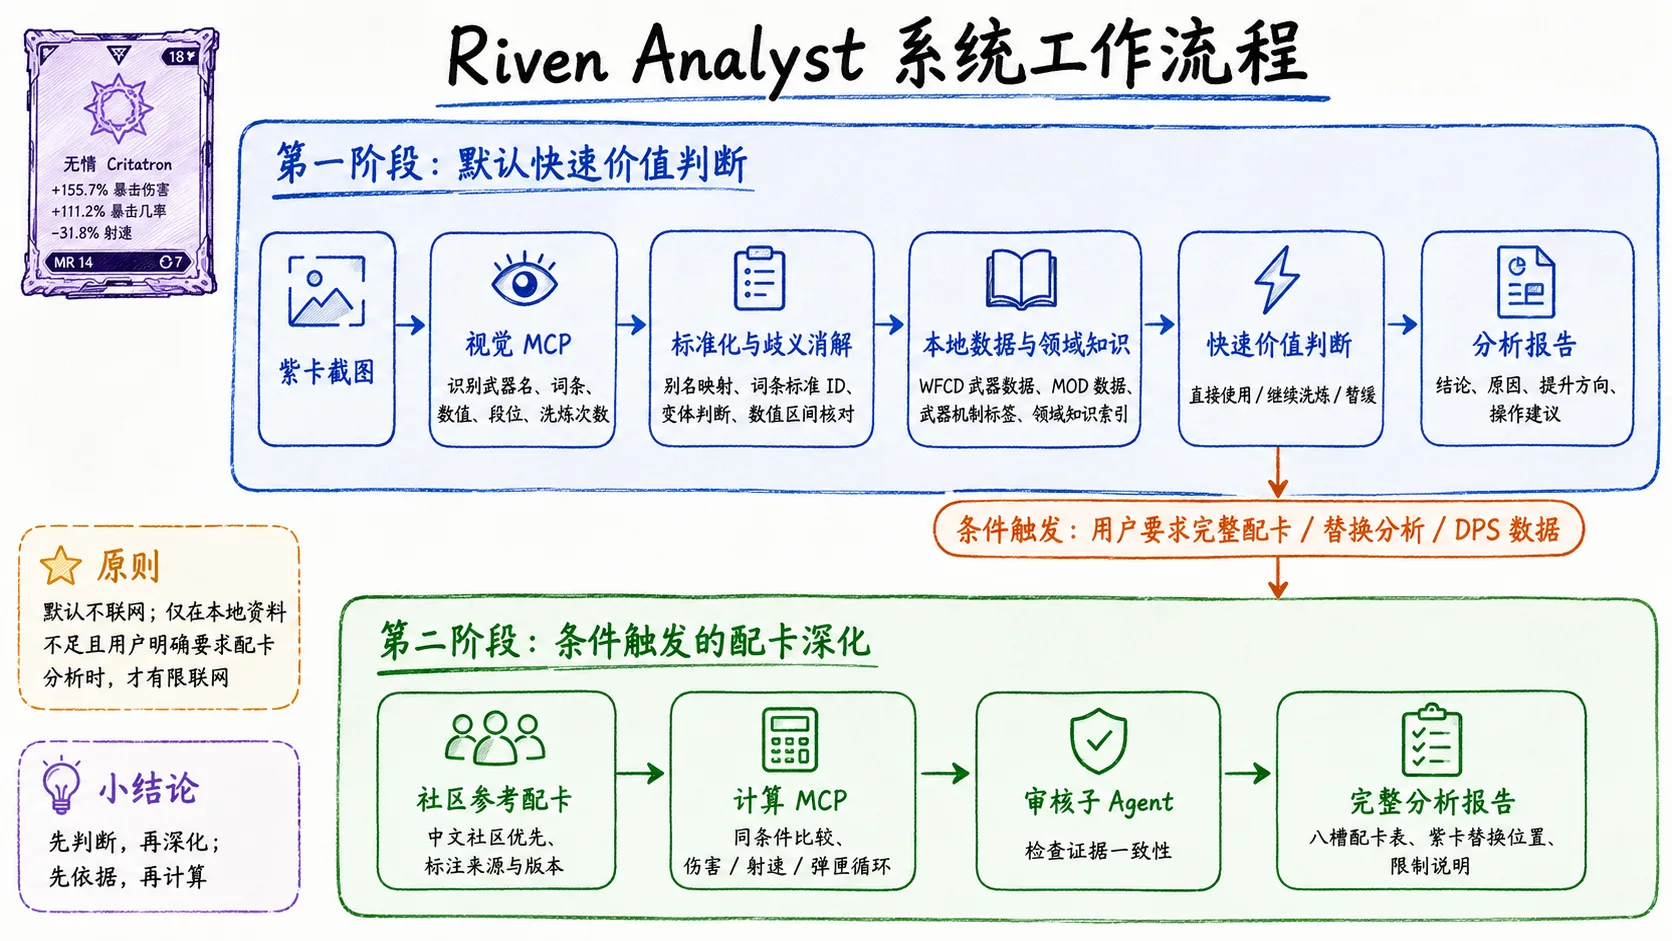
从一张紫卡开始:Riven Analyst 背后的 Agent、Harness 与从 0 到 12026-08-022026-08-14技术笔记/碎影Warframe/AI Agent/Harness Engineering/从0到1复盘 Warframe 紫卡助手 Riven Analyst 的系统架构,并聊聊我在开发中对用户、Harness、旧工具边界和从 0 到 1 的思考。2026-08-02|60|0|0
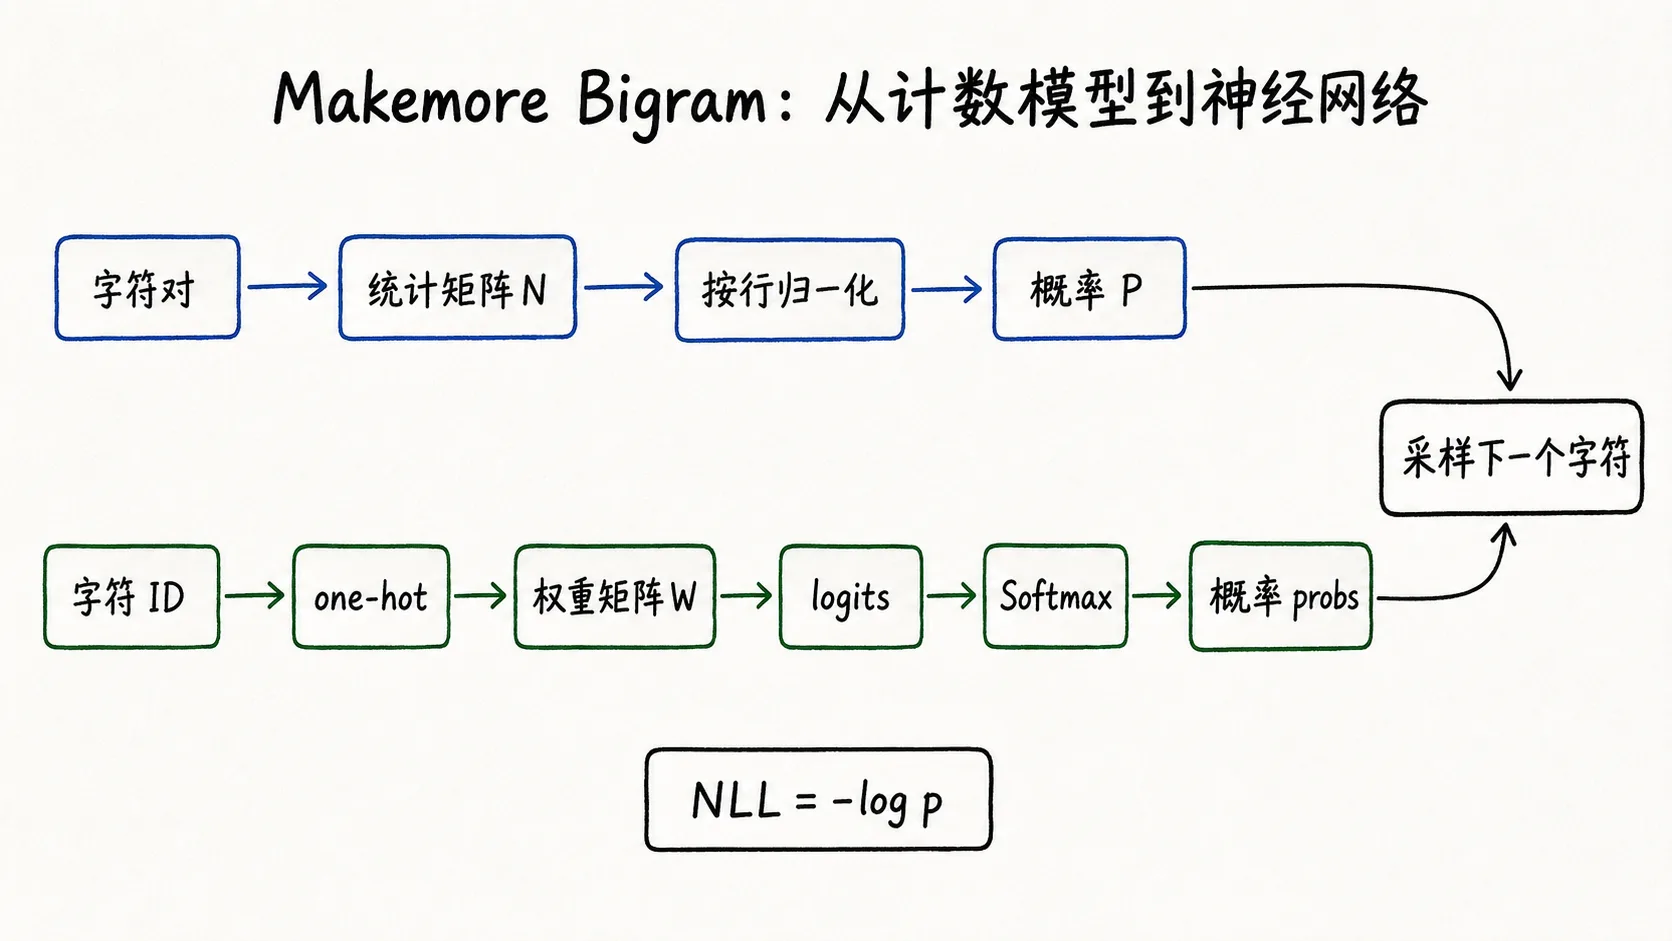
从计数矩阵到神经网络:Karpathy Bigram 模型复现2026-07-292026-08-14技术笔记transformer/bigram/负对数似然/logits/人工智能本文是 Karpathy makemore 课程 Bigram 模型的复现笔记,分别用计数矩阵和单层神经网络两种方式实现字符级语言模型。2026-07-29|23|0|0
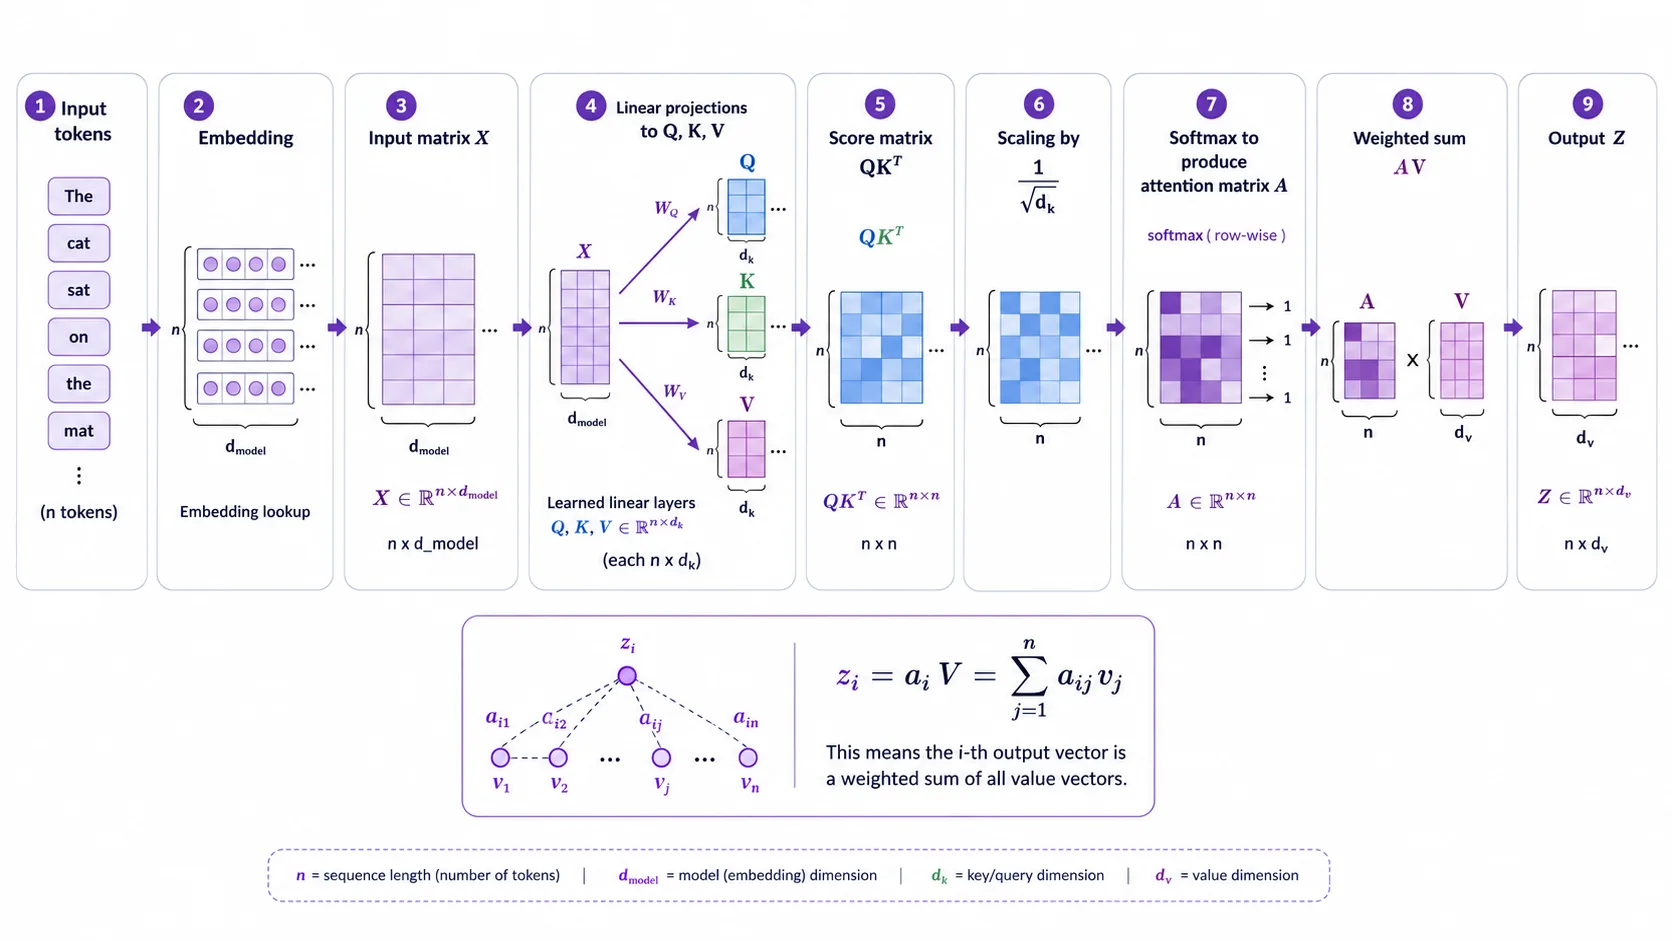
Transformer 自注意力机制详解:从单头推导到多头注意力2026-07-152026-08-14技术笔记transformer/self-attention/Multi-Head Attention自注意力是 Transformer 架构的核心组件。它使模型在处理序列中的某个词时,不是孤立地编码该词,而是同时考察同一序列中所有其他词,计算它们与该词之间的相关性权重。本文从单个 token 的视角入手,再逐步展开为矩阵形式,依次推导 Q、K、V 的线性投影过程、缩放点积注意力的计算方式,以及多头注意力的拼接与融合机制。2026-07-15|116|0|0
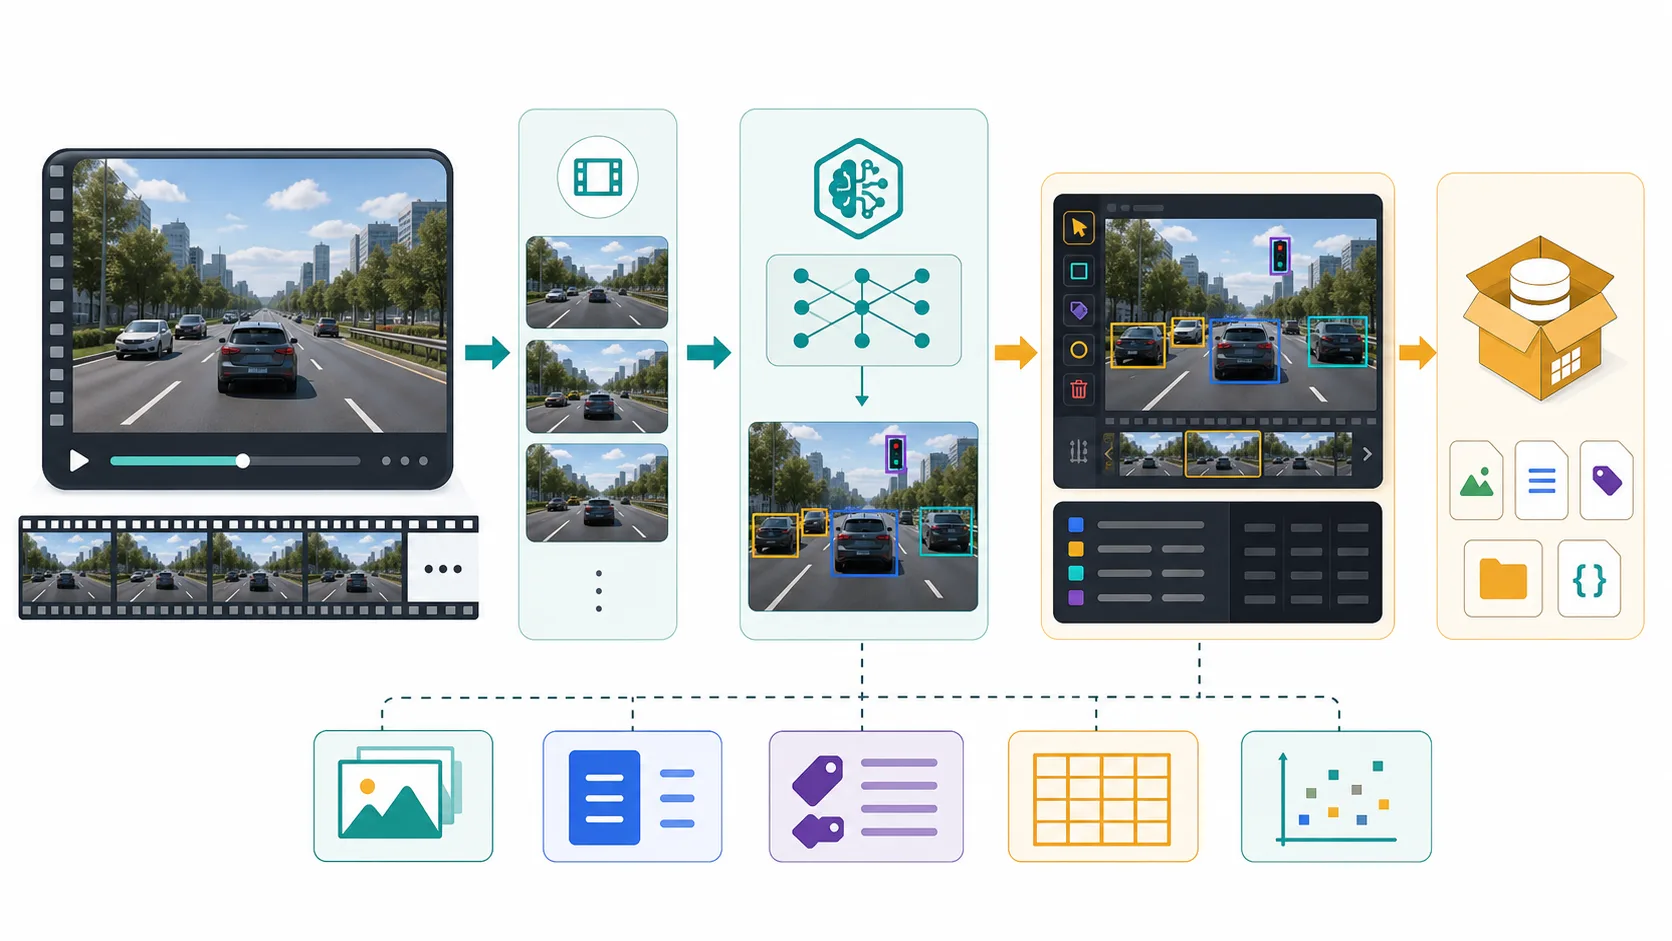
从 AI 生成视频到目标检测数据集:一次本地 VLM 标注管线的工程记录2026-06-092026-08-14技术笔记VLM/Ollama/Qwen3-VL/数据处理从 AI 生成视频到 YOLO 能用的 COCO 数据集,中间隔着一整条工程管线。这篇文章记录了搭建过程:本地 Qwen3-VL做预标注,逐帧缓存保证任务可恢复,人工审核后再导出标准格式。2026-06-09|197|0|0
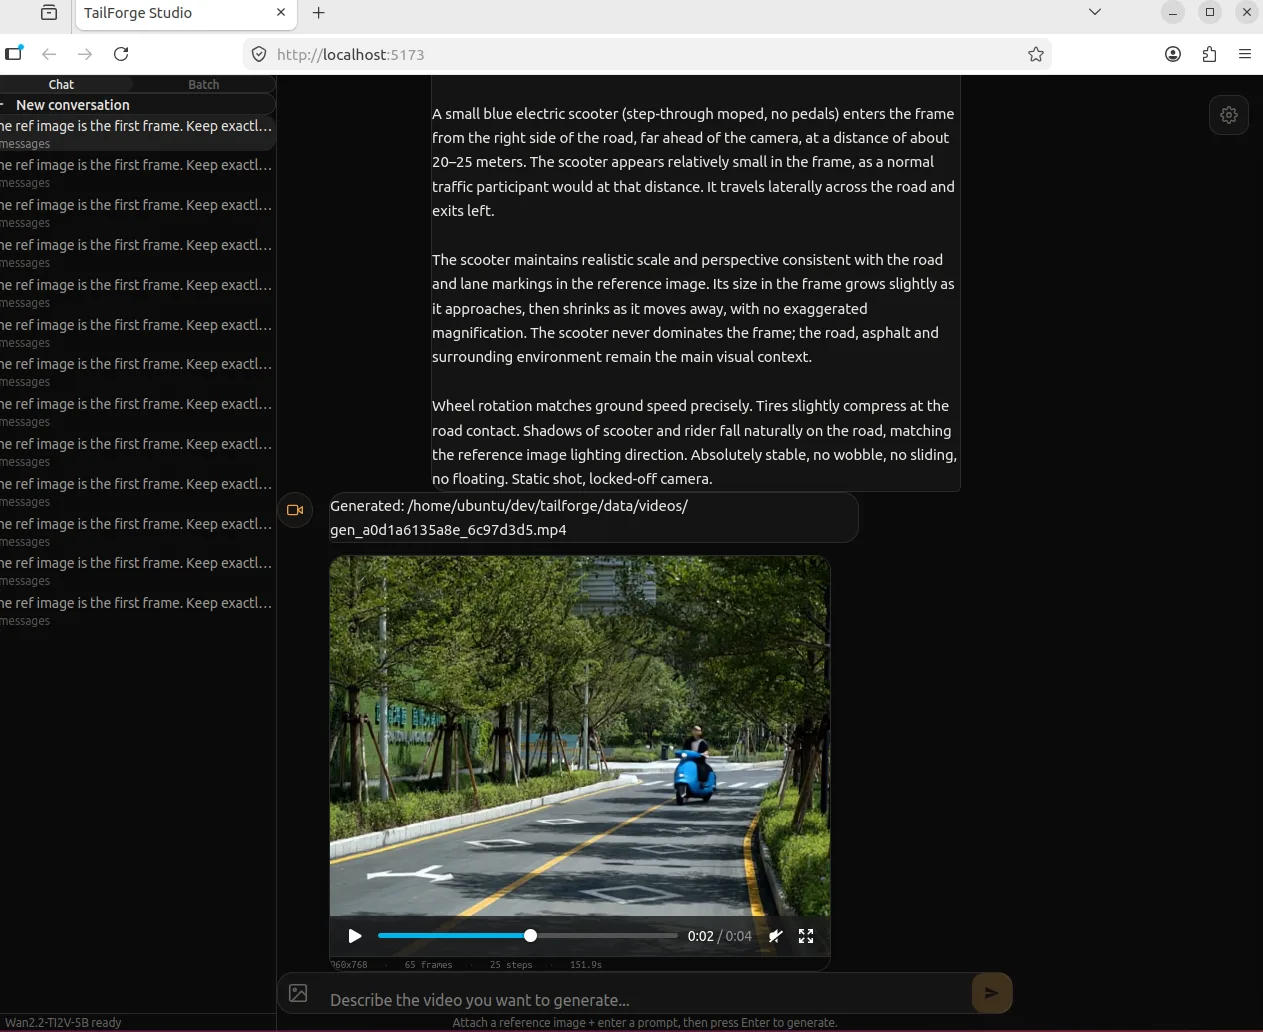
自动驾驶数据长尾分布问题:本地部署Wan2.2-TI2V-5B合成数据实践2026-06-082026-08-14技术笔记视频生成模型/合成数据/Wan 2.2/本地推理上篇文章用即梦验证了视频生成模型合成长尾数据的可行性,但商业 API 成本高、数据要上传。这篇文章记录了在 RTX 4090工作站上本地部署 Wan2.2-TI2V-5B 开源图生视频模型的过程。围绕模型搭了一个工具(FastAPI +React),支持对话式单次生成和批量排队合成,生成后自动抽帧。2026-06-08|44|0|0